摘要
HNSW 为什么是艾体宝 Qdrant 高性能检索的“骨架”?从多层导航图、三个核心参数,到 Filterable HNSW、ACORN、查询规划与存储优化,一次讲清 Qdrant 如何把近似最近邻算法变成可落地的向量检索系统。
从多层导航图、三个核心参数,到 Filterable HNSW、ACORN、查询规划与存储优化,一次讲清 Qdrant 如何把近似最近邻算法变成可落地的向量检索系统。
在 RAG、语义搜索、智能客服和推荐系统中,向量数据库要回答的并不只是”谁和 Query 最像”。真正的业务问题往往是:
在百万乃至亿级向量中,如何在满足租户、权限、状态、时间等条件的前提下,快速找到最相关的 Top-K,并把延迟、召回率和资源成本控制在可接受范围内?
HNSW 解决了其中最核心的一步——如何不扫描全部向量,也能快速接近真正的近邻。
艾体宝 Qdrant 则继续向前走了一步:它把 HNSW 与业务过滤、查询规划、分片分段、后台优化、磁盘存储和量化机制组合起来,形成了一套生产级检索链路。
如果只记住一句话,可以记住这句:
为什么不能永远使用暴力搜索?
Query Vector = [0.23, 0.81, 0.14, …]
精确搜索需要把 Query 与 100 万个向量逐一计算距离,再从结果中选出 Top-K。它的优势是结果准确,代价是计算量会随数据规模近似线性增长。
当查询量、向量维度和数据规模同时上升时,问题会迅速放大:
- 数据从 10 万增长到 1 亿,单次查询需要比较的向量数量增加约 1000 倍;
- 多租户、高并发场景会让距离计算持续消耗 CPU;
- 即使磁盘能装下全部向量,延迟也未必能满足在线业务的 SLA。
HNSW 的目标不是”免费获得完全准确的结果”,而是:
只检查一小部分更有希望的候选向量,用少量、可调节的召回损失,换取数量级上的检索加速。
因此,HNSW 属于 ANN(Approximate Nearest Neighbor,近似最近邻)算法。
先建立直觉:HNSW 是一张多层导航地图
HNSW 的全称是 Hierarchical Navigable Small World。可以把它理解成一张”多层道路网络”:
- 上层节点少、跨度大,像高速公路,负责快速跳到目标区域;
- 中间层像城市主干道,负责缩小搜索范围;
- Layer 0 包含全部向量,像社区道路,负责在局部仔细寻找 Top-K。
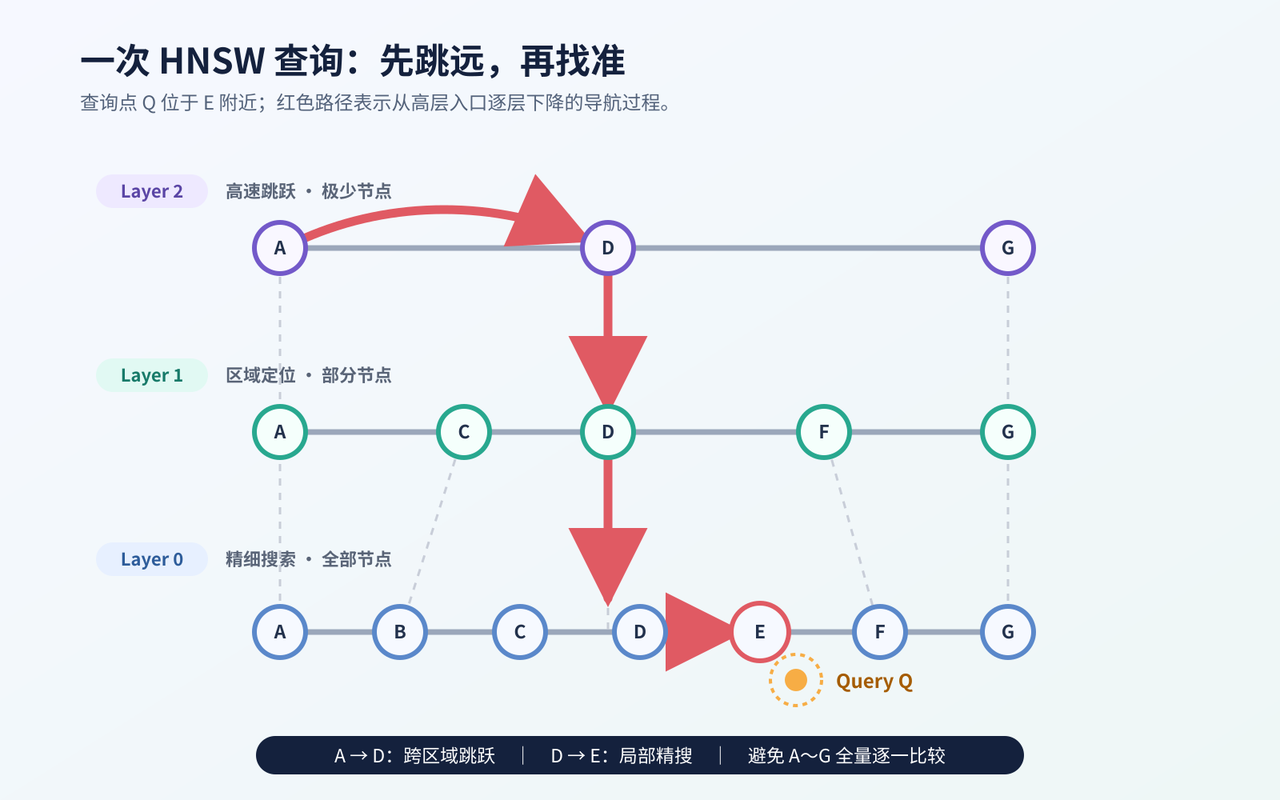 图 1:红色路径表示 Query 从入口 A 出发,经 D 快速接近 E 所在区域。
假设有二维向量 A~G,Query 位于 E 附近。传统扫描会逐一比较 A、B、C、D、E、F、G;HNSW 则可能经历:
| 阶段 | 路径 |
|---|---|
| 最高层 | A → D 快速跨区域跳跃 |
| 中间层 | 围绕 D 定位缩小搜索范围 |
| 最底层 | D → E 展开局部候选并返回 Top-K |
真实实现并不是一次性比较最高层的所有节点,而是从入口开始进行贪心导航:只要邻居比当前节点更接近 Query,就继续向更好的邻居移动;无法继续改善时,再下降一层。
这种设计的价值在于:把”全局找针”变成”先找到大致街区,再在街区内找门牌号”。
多层图是怎样建出来的?
HNSW 不需要先运行一次聚类来挑选”中心节点”。每插入一个新向量时,系统会随机为它分配最高层级,而且进入更高层的概率会快速衰减。
因此通常会形成:
| Layer 3:极少数节点 |
| Layer 2:少量节点 |
| Layer 1:较多节点 |
| Layer 0:全部节点 |
如果节点 x 的最高层级是 Layer 1,那么它会同时存在于 Layer 1 和 Layer 0,但不会进入 Layer 2。
插入 x 的过程可以概括为:
- 随机确定 x 的最高层级;
- 从当前最高层入口开始,逐层寻找更接近 x 的区域;
- 在 x 能进入的每一层保留一批候选邻居;
- 从候选中选择部分节点,与 x 建立连接;
- 当节点连接过多时,执行裁剪,尽量兼顾距离和方向多样性。
※邻居选择并不等于”机械地保留最近的几个点”。如果所有边都指向同一方向,图容易形成局部拥堵,跨区域导航能力也会变差。HNSW 的启发式选择会尽量保留具有导航价值的连接。
一个完整的查询过程是怎样的?
假设:
| Query 位于 E 附近 |
| 入口节点是 A |
第一步:从最高层进入
最高层只有:
A — D — G
计算 Query 与 A、D、G 的距离。
假设:
| Query 到 A:很远 |
| Query 到 D:较近 |
| Query 到 G:较远 |
搜索从 A 移动到 D。
此时不用经过 B、C,就已经快速从 A 跳到了 D 附近。
第二步:进入中间层
从 D 对应的 Layer 1 节点开始。
Layer 1 可能是:
A — C — D — F — G
继续比较 D 的邻居:
- C 比 D 更远;
- F 也可能比 D 更远;
- D 仍然是当前最好节点。
于是从 D 下降到 Layer 0。
第三步:在最底层精细搜索
Layer 0 包含:
A、B、C、D、E、F、G
从 D 开始检查附近节点:
D → E
D → C
E → F
发现 E 与 Query 最接近,最终返回 E 以及 E 附近的其他 Top-K 节点。
完整过程相当于:
最高层:A → D
中间层:D 附近定位
最底层:D → E,并检查 E 周围候选
而不是:
A、B、C、D、E、F、G 全部比较
三个参数,控制三个不同阶段
HNSW 最常见的三个参数是 m、ef_construct 和 hnsw_ef。
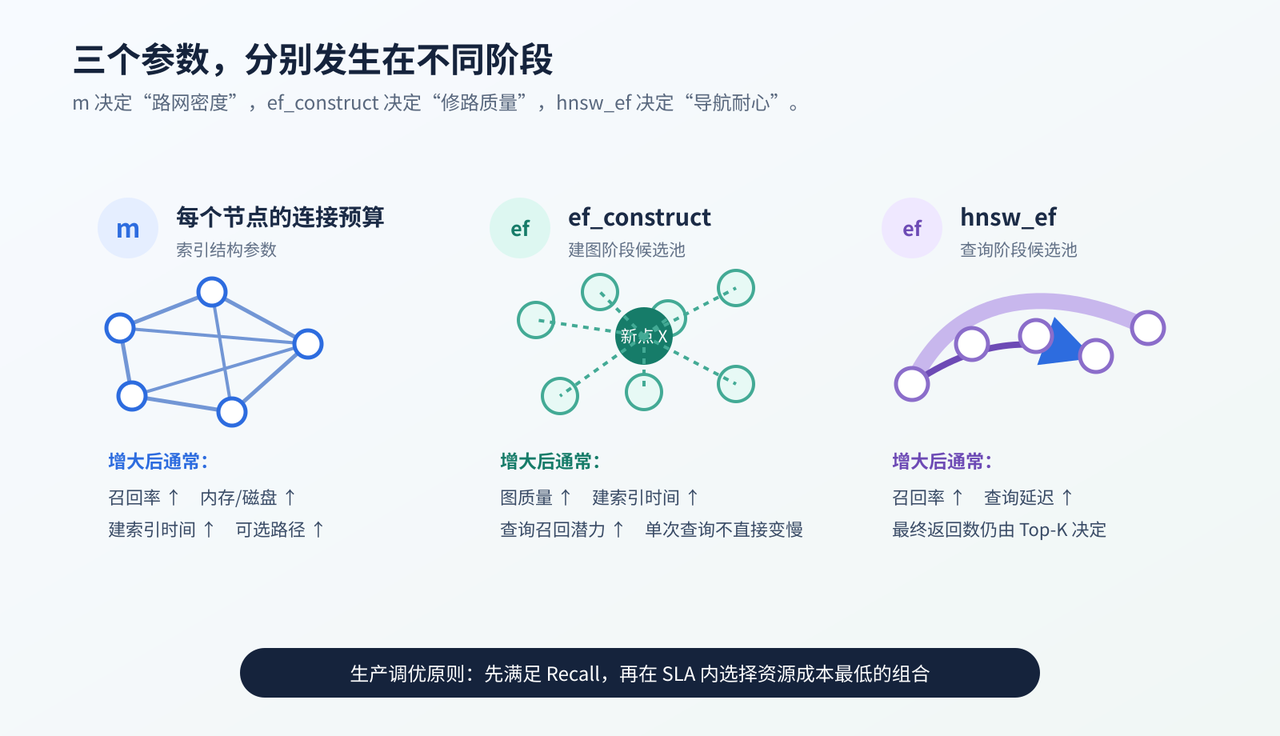
图 2:三者共同影响召回率,但付出的成本并不相同。
| 参数 | 生效阶段 | 直观含义 | 增大后的典型影响 |
|---|---|---|---|
| m | 建图 | 每个节点的连接预算 | 召回率 ↑ 内存/磁盘 ↑ 建索引时间 ↑ 可选路径 ↑ |
| ef_construct | 建图 | 建图阶段候选池 | 图质量 ↑ 建索引时间 ↑ 查询召回潜力 ↑ 单次查询不直接变慢 |
| hnsw_ef | 查询 | 查询阶段候选池 | 召回率 ↑ 查询延迟 ↑ 最终返回数仍由 Top-K 决定 |
生产调优原则:先满足 Recall,再在 SLA 内选择资源成本最低的组合。
m:每个节点有多少条可选道路
m 较小时,图更稀疏,占用资源更少,但关键路径不足时更容易错过真实近邻。m 较大时,节点之间有更多替代路线,通常有利于召回率,但会增加索引体积、建图成本和邻居遍历工作量。
需要注意,m 更适合被理解为连接预算或上限,而不是”每个节点一定恰好有 m 条边”。
ef_construct:图本身修得好不好
插入新节点 X 时,系统必须先在已有图中寻找合适的邻居。ef_construct 越大,建图时考察的候选越多,错过关键连接的概率通常越低。
它决定的是离线建图质量,不会像 hnsw_ef 一样直接成为每次查询的候选规模。可以把它理解成修路阶段的勘探预算。
hnsw_ef:查询时愿意探索多少可能路线
查询进入 Layer 0 后,会维护待探索候选和当前最好结果。hnsw_ef 越大,系统越愿意继续探索其他分支,找到真实近邻的概率通常越高,但查询耗时也会增加。
hnsw_ef 不等于最终返回数量。例如:
Top-K = 10
hnsw_ef = 128
表示搜索阶段可以保留和探索较大的候选池,但最终仍只返回 10 条结果。
为什么 HNSW 可能”找错”?
HNSW 没有查看所有向量,因此存在近似误差。
假设真实最近邻 X 位于另一个图分支,但搜索从入口出发进入了局部区域 C。如果图的连接不足、建图时缺少关键边,或者查询阶段过早停止,就可能返回 C 而不是 X。
提高以下参数通常可以降低这种风险:
| 参数 | 作用 |
|---|---|
| m 增大 | 图中可选路径更多 |
| ef_construct 增大 | 图的连接质量通常更高 |
| hnsw_ef 增大 | 查询时探索更多候选分支 |
但三者都不是免费的:
- 更多连接意味着更高内存或磁盘占用;
- 更多建图候选意味着更长索引构建时间;
- 更多查询候选意味着更高延迟。
因此,HNSW 的核心并不是”把参数拉满”,而是让召回率、P95 延迟、构建时间和资源成本达到业务可接受的平衡。
艾体宝 Qdrant 不只是”用了 HNSW”
如果把原始 HNSW 看作一张高效的导航图,Qdrant 的价值在于:它让这张图能够进入真实业务环境。
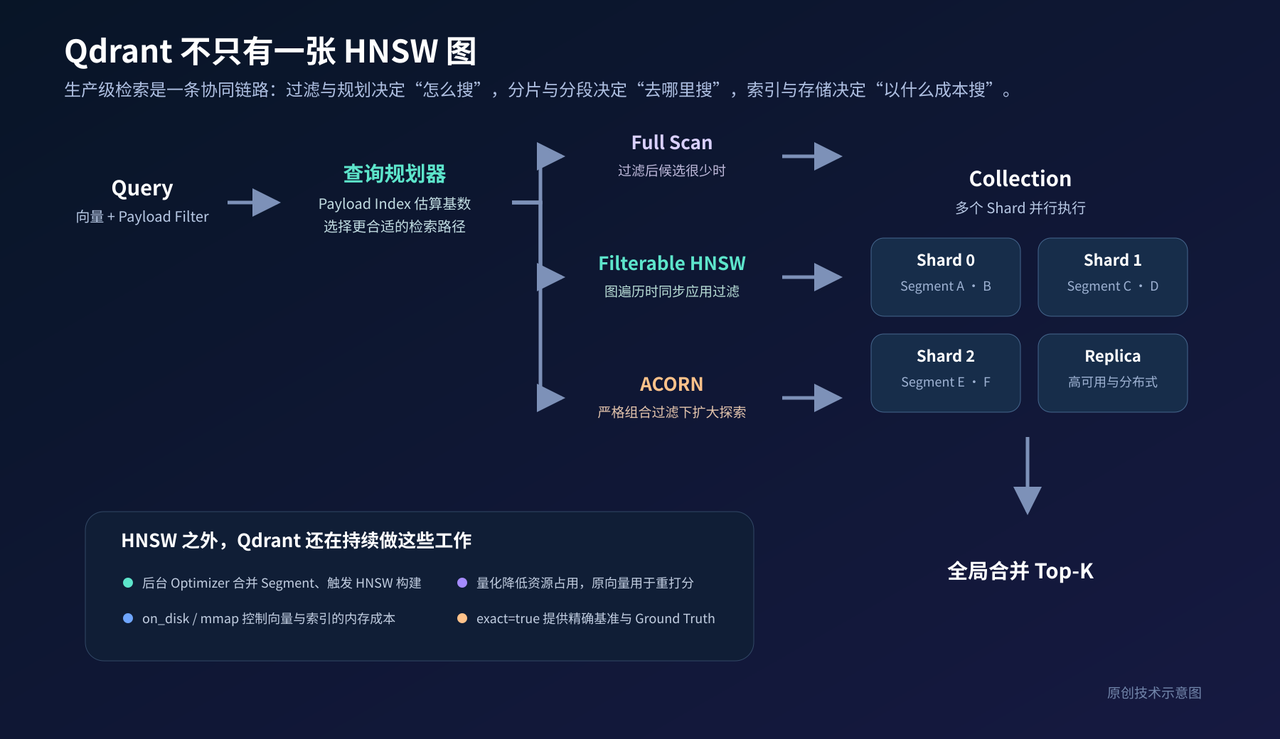
图 3:一次查询可能经过过滤基数估算、策略选择、分片分段检索和全局 Top-K 合并。
Qdrant 不只有一张 HNSW 图。生产级检索是一条协同链路:过滤与规划决定”怎么搜”,分片与分段决定”去哪里搜”,索引与存储决定”以什么成本搜”。
Filterable HNSW:让过滤发生在图遍历过程中
业务查询通常不是纯向量检索,而是:
寻找与 Query 最相关的文档 AND tenant_id = A AND status = published AND department IN [sales, support]
如果先做普通 HNSW,再对结果做过滤,可能出现一个问题:前 100 个近邻大多不符合条件,过滤后只剩 2 条;如果先过滤再暴力扫描,在中等选择率下又可能很慢。
Qdrant 的 Filterable HNSW 会利用 Payload Index,在 HNSW 图中增加与过滤值有关的连接,并在图遍历期间直接应用过滤条件。这样,向量相似度和业务约束不必被拆成两个互不理解的步骤。
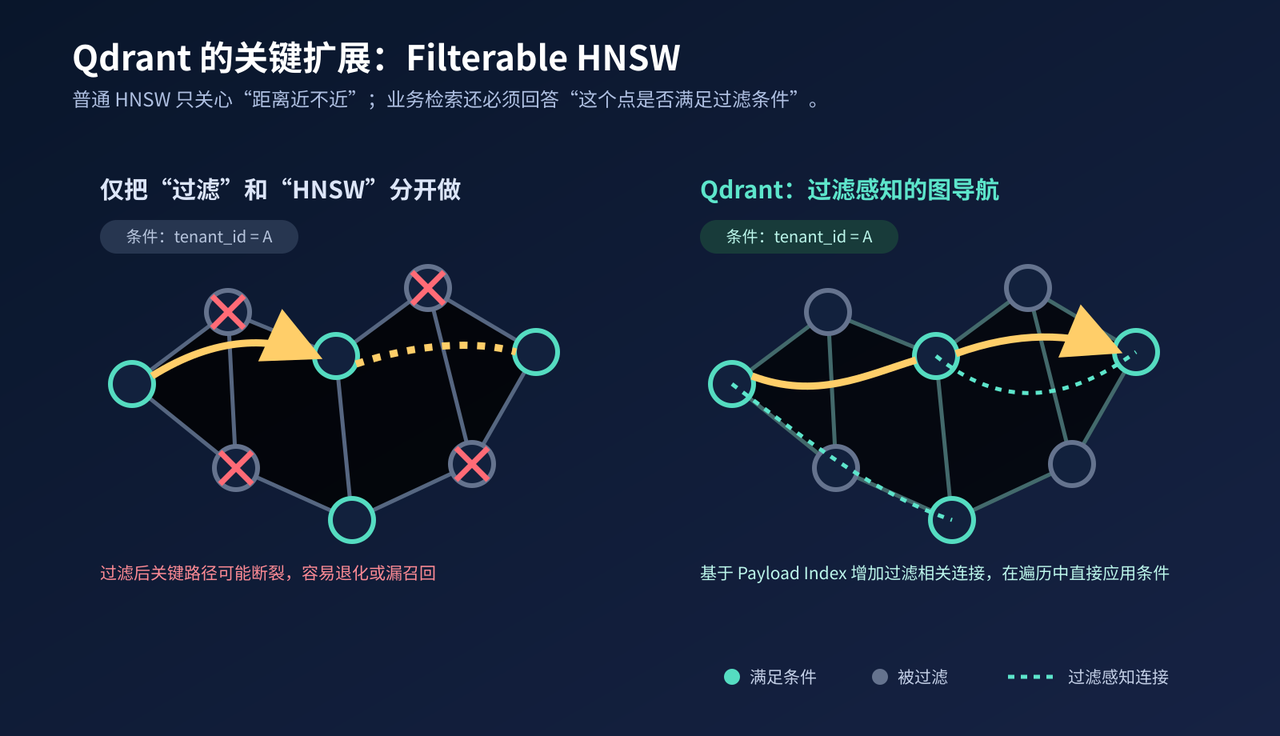
图 4:过滤会让普通图中的部分路径失效;过滤感知连接帮助搜索继续到达符合条件的候选区域。
这也是为什么 Qdrant 官方建议:对高频过滤字段尽早创建 Payload Index,最好在大规模数据写入前完成。这样后台构建 HNSW 时就能把过滤相关连接纳入图结构。
对于严格的组合过滤或大量软删除数据,Qdrant 还提供 ACORN 搜索策略。它会在直接邻居大量被过滤时,进一步探索邻居的邻居,以额外计算成本换取更好的过滤召回表现。
查询规划:小范围扫描,大范围走 HNSW
过滤后只剩 10 个候选时,计算 10 次距离通常比启动 HNSW 图搜索更划算;过滤后仍有 50 万个候选时,HNSW 更有价值。
Qdrant 可以使用 Payload Index 提供的基数估计,在不同检索路径之间做选择。full_scan_threshold 就参与了这类决策。
一个特别容易被误解的细节是:
full_scan_threshold 的单位是 KB 级向量数据量,不是 Point 数量。
因此,full_scan_threshold = 10 表示约 10 KB 的向量数据阈值,而不是”过滤后少于 10 个 Point 就扫描”。不同向量维度对应的 Point 数量不同,不能直接把这个值当作条数。
Collection、Shard、Segment:实际并非只有一张图
学习算法时,可以先把一个 Collection 想成一张 HNSW 图。但在 Qdrant 的实际存储中,数据会组织成:
Collection → Shard → Segment
因此,Qdrant 处理的是一个系统级问题:
召回率 × 查询延迟 × 内存占用 × 磁盘占用 × 建索引时间
HNSW 负责高效导航,存储与量化机制负责让这套导航能力在不同硬件预算下落地。
一个更准确的 Qdrant 配置示例
下面用 REST 配置展示参数所处的位置。数值仅用于说明,生产环境必须以实测结果为准;不同 Qdrant 版本的默认值也可能变化。
PUT /collections/hnsw_demo
{
  "vectors": {
    "size": 768,
    "distance": "Cosine",
    "on_disk": true
  },
  "hnsw_config": {
    "m": 16,
    "ef_construct": 100,
    "full_scan_threshold": 10000,
    "on_disk": true
  },
  "optimizers_config": {
    "indexing_threshold": 20000
  },
  "on_disk_payload": true
}
查询阶段再通过 hnsw_ef 控制搜索范围:
POST /collections/hnsw_demo/points/query
{
  "query": [0.23, 0.81, 0.14],
  "params": {
    "hnsw_ef": 128,
    "exact": false
  },
  "limit": 10,
  "with_payload": true
}
如果设置:
"exact": true
Qdrant 会绕过 HNSW,执行精确搜索。它适合生成 Ground Truth、验证召回率,或者在数据规模较小时作为基线,但通常不是大规模在线查询的首选路径。
怎样从业务指标反推参数?
生产调优不应该从”网上推荐 m = 16 还是 m = 32″开始,而应该从业务目标开始。
推荐验证流程是:
- 固定数据集、Query 集合、Top-K 和过滤条件;
- 使用 exact=true 生成 Ground Truth;
- 分组测试不同 m 和 ef_construct,等待索引完成;
- 对每组索引测试多个 hnsw_ef;
- 先筛选 Recall 达标的配置;
- 再剔除 P95 延迟不满足 SLA 的配置;
- 在剩余方案中优先选择索引更小、构建更快的组合;
- 检查 indexed_vectors_count、Segment 数量和 Optimizer 状态,避免”部分 Plain Search”让实验结果失真。
例如,下面两种方案都可能达到相似 Recall:
方案 A:m 较小 + hnsw_ef 很大
索引较省,但每次查询需要更努力
方案 B:m 和 ef_construct 较高 + hnsw_ef 适中
建图更贵,但在线查询可能更稳定
最终选择取决于业务是”写多查少””写少查多”,还是对内存、冷启动、P95 延迟有更严格要求。
四个常见误区
误区一:HNSW 能保证返回真实 Top-K
不能。HNSW 是近似检索算法。需要用精确搜索构造 Ground Truth,再用 Recall@K 衡量它找回了多少真实近邻。
误区二:所有参数越大越好
参数增大通常意味着更高资源成本。生产配置的目标是”满足业务指标的最低成本”,而不是参数最大化。
误区三:一个 Collection 就是一张 HNSW 图
这是便于学习的简化。实际索引位于 Segment 层;查询需要跨 Segment、Shard 获取局部候选并合并。
误区四:full_scan_threshold 和 indexing_threshold 表示向量条数
两者都使用 KB 级数据量口径。向量维度不同,相同阈值对应的向量条数也不同。
总结:HNSW 是骨架,艾体宝 Qdrant 是完整的系统
HNSW 的核心流程可以压缩成两句话:
建图阶段:随机分层 → 逐层定位 → 用 ef_construct 寻找候选 → 用 m 控制连接
查询阶段:高层快速跳跃 → Layer 0 用 hnsw_ef 扩展候选 → 返回 Top-K
而 Qdrant 在此基础上继续解决了真实业务中的关键问题:
- 用 Filterable HNSW 和 ACORN 处理”语义相关且满足业务条件”;
- 用 Payload Index 和查询规划决定走 Full Scan 还是图搜索;
- 用 Shard、Segment 和 Optimizer 管理分布式数据与后台索引;
- 用 on_disk、内存映射和量化控制资源成本;
- 用精确搜索提供可验证的召回率基线;
- 用局部检索与全局合并,返回 Collection 范围内的 Top-K。
所以,Qdrant 的价值不只是”集成了一个 HNSW 算法”。更准确地说,它把一个优秀的 ANN 算法扩展成了可过滤、可规划、可分布、可优化、可验证的生产级向量检索系统。
对客户而言,最终获得的也不只是”搜索更快”,而是:
在业务规则不被牺牲的前提下,用可控的准确率与资源成本,稳定支撑更大规模、更高并发的语义检索。
注:本文示意图均为原创绘制,用于解释算法与产品机制,不代表 Qdrant 内部数据结构逐行实现。